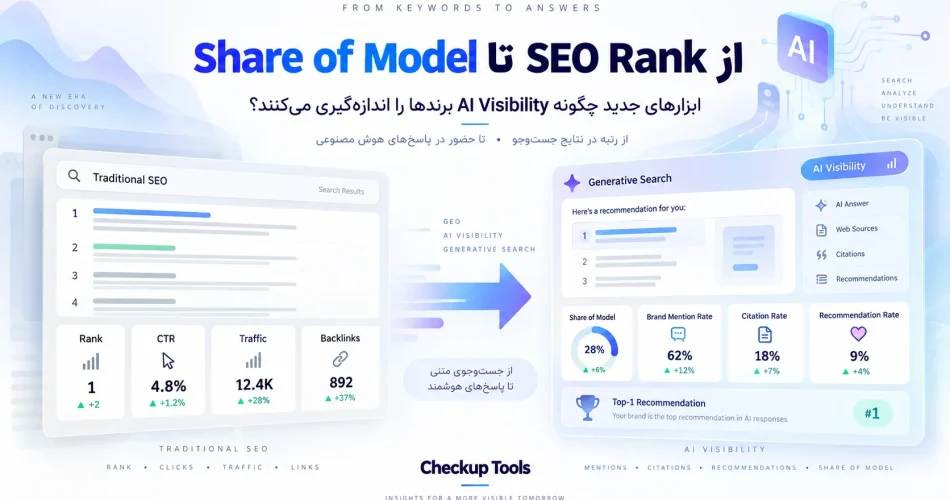
تقی مولوی : با رشد ChatGPT، Gemini، Claude و Perplexity، مفهوم Visibility در Search در حال تغییر است.
در مدل سنتی جستوجو، ابزارهای SEO معمولاً روی Rank، Impression، CTR، Backlink، Crawlability و Organic Traffic تمرکز داشتند.
اما در Generative Search، کاربر ممکن است بدون مشاهده فهرست لینکها، پاسخ نهایی را مستقیماً از یک مدل هوش مصنوعی دریافت کند.
در چنین شرایطی یک سؤال جدید برای متخصصان SEO، Growth و Marketing شکل میگیرد:
وقتی کاربر مستقیماً پاسخ AI را میگیرد، دیدهشدن یک برند را با چه Metricهایی باید سنجید؟
پاسخ این سؤال در حال شکلدادن به حوزهای است که امروز با نامهایی مانند GEO، Generative Engine Optimization، AI Visibility، LLM Visibility و Generative Search Measurement شناخته میشود.
در این گزارش، Checkup Tools به بررسی چند مفهوم کلیدی و مجموعهای از ابزارهای متنباز میپردازد که برای اندازهگیری دقیقتر Visibility برندها در پاسخ مدلهای مولد توسعه داده شدهاند.
چرا Rank Trackerهای سنتی برای Generative Search کافی نیستند؟
در Search کلاسیک، موقعیت یک URL در SERP تا حد زیادی قابل مشاهده و قابل ثبت بود.
اگر سایتی در رتبه سوم یک Query قرار داشت، ابزارهای مختلف میتوانستند تقریباً همان وضعیت را ثبت کنند.
اما پاسخهای Generative Engineها چنین رفتار ثابتی ندارند.
نتیجه میتواند بر اساس عوامل مختلف تغییر کند:
- نوع Prompt
- نحوه بیان سؤال
- مدل مورد استفاده
- زبان و بازار
- زمان اجرا
- منابع قابل Retrieval
- Grounding System
- Context گفتگو
به همین دلیل، بررسی یک پاسخ واحد از ChatGPT یا Perplexity نمیتواند تصویر قابلاعتمادی از وضعیت یک برند ارائه کند.
یک Screenshot بیشتر یک Observation است تا Benchmark.
GEO Benchmark چیست؟
GEO Benchmark را میتوان فرآیندی برای اندازهگیری تکرارشونده Visibility برندها در مجموعهای از Promptها و مدلهای مختلف تعریف کرد.
بهجای اجرای یک Query، یک Benchmark میتواند صدها یا هزاران Prompt را در Intentهای مختلف بررسی کند.
برای مثال:
Informational
CRM چیست؟
Comparative
HubSpot بهتر است یا Salesforce؟
Commercial
بهترین CRM برای کسبوکار کوچک چیست؟
Recommendation
برای تیم فروش ۲۰ نفره چه CRMای پیشنهاد میشود؟
Problem / Solution
چطور Follow-up لیدهای فروش را اتوماتیک کنیم؟
تمام این Promptها در یک Topic Cluster قرار دارند، اما ممکن است Recommendationها و Citationهای کاملاً متفاوتی ایجاد کنند.
هدف Benchmark، کاهش Bias ناشی از انتخاب چند Query محدود و ایجاد یک Dataset قابلتحلیل است.
Share of Model چیست؟
یکی از Metricهایی که در بحث AI Visibility بیشتر دیده میشود، Share of Model است.
این مفهوم را میتوان مشابه Share of Voice در Search کلاسیک در نظر گرفت.
Share of Model نشان میدهد یک برند در چه سهمی از پاسخهای مرتبط یک مدل، در مقایسه با رقبا، حضور دارد.
برای مثال فرض کنید در یک Benchmark شامل ۱۰۰۰ اجرای مرتبط نتایج زیر ثبت شود:
- Brand A: 320 Mention
- Brand B: 240 Mention
- Brand C: 160 Mention
- Brand D: 80 Mention
در این Dataset، Brand A بیشترین Presence را دارد.
اما این عدد بهتنهایی کافی نیست.
یک برند ممکن است زیاد Mention شود اما کمتر Recommended شود.
برندی دیگر ممکن است Mention کمتری داشته باشد اما Source اصلی Citationها باشد.
بنابراین Share of Model باید در کنار Metricهای دیگر بررسی شود.
Metricهای اصلی AI Visibility
Brand Mention Rate
در چند درصد پاسخهای مرتبط، نام برند ظاهر شده است؟
Citation Rate
در چند درصد پاسخها، Domain یا محتوای برند بهعنوان Source استفاده شده است؟
Recommendation Rate
در چند درصد پاسخها، برند واقعاً به کاربر پیشنهاد شده است؟
Top-1 Recommendation Rate
در چند درصد پاسخها، برند بهعنوان انتخاب اصلی مدل معرفی شده است؟
Competitor Visibility
حضور برند در مقایسه با مجموعه رقبا چگونه است؟
Share of Model
سهم کلی برند از مجموعه پاسخهای مرتبط چقدر است؟
Citation و Recommendation یک چیز نیستند
یکی از نکات مهم در تحلیل GEO این است که Citation را نباید معادل Recommendation دانست.
یک مدل ممکن است:
- اطلاعات را از Website A استخراج کند،
- Website B را بهعنوان Source نمایش دهد،
- اما Brand C را به کاربر پیشنهاد کند.
در چنین حالتی سه نوع Visibility متفاوت وجود دارد.
Source Visibility
محتوا تا چه اندازه در Retrieval و Citation حضور دارد؟
Brand Visibility
نام یا Entity برند تا چه اندازه در پاسخ ظاهر میشود؟
Recommendation Visibility
مدل تا چه اندازه برند را بهعنوان گزینه پیشنهادی معرفی میکند؟
این تفکیک یکی از مهمترین تفاوتهای بین تحلیل سطحی AI Search و یک Benchmark واقعی GEO است.
GEO-Scope؛ یک چارچوب متنباز برای Benchmark کردن AI Visibility
یکی از پروژههایی که با تمرکز بر همین مسئله توسعه داده شده، GEO-Scope است.
این پروژه توسط تقی مولوی (Taqi Molavi) توسعه داده شده و بهصورت Open Source در GitHub منتشر شده است.
GEO-Scope تلاش میکند فرآیند بررسی GEO را از یک مجموعه ادعای غیرقابلسنجش به یک Workflow آزمایشپذیر تبدیل کند.
منطق اصلی پروژه را میتوان در این چرخه خلاصه کرد:
Baseline → Change → Re-test → Compare
در یک Benchmark قابلدفاع، اطلاعاتی مانند موارد زیر اهمیت دارند:
- Prompt Set
- مدلهای مورد استفاده
- Brand و Competitor Set
- Language
- Market
- Timestamp
- Raw Responses
- Citation Data
- Metrics
این موضوع باعث میشود نتایج نه بهعنوان قانون قطعی، بلکه بهعنوان خروجی یک Experiment مشخص بررسی شوند.
چرا ۱۰۰۰ Prompt؟
در Benchmarkهای AI Visibility، عددهایی مانند ۱۰۰۰ Prompt بیشتر از آنکه یک عدد جادویی باشند، برای ایجاد Diversity استفاده میشوند.
اگر Visibility یک برند تنها با چند Prompt محدود اندازهگیری شود، نتیجه میتواند بهشدت تحت تأثیر Query Selection قرار گیرد.
Prompt Variation کمک میکند بررسی شود که یک برند فقط در یک نوع سؤال دیده میشود یا در چند Intent مختلف Presence پایدار دارد.
بنابراین ارزش یک Benchmark فقط به تعداد Prompt وابسته نیست.
کیفیت Dataset، Intent Coverage و تکرارپذیری آزمایش نیز اهمیت زیادی دارند.
Promptها باید از کجا بیایند؟
یکی از مشکلات مهم در GEO Research این است که Generated Prompt با Observed Demand اشتباه گرفته شود.
اگر یک مدل هوش مصنوعی هزار سؤال احتمالی تولید کند، این بهمعنای آن نیست که کاربران واقعاً چنین سؤالهایی را مطرح کردهاند.
در همین زمینه، پروژه AnswerPath GEO با هدف استخراج و طبقهبندی Questionها توسعه داده شده است.
این پروژه نیز توسط Taqi Molavi توسعه یافته و میان دو نوع داده تفاوت قائل میشود:
- Observed Questions
- Generated Research Prompts
Observed Questions میتوانند از Dataset، Support Log یا Conversation Export استخراج شوند.
Generated Prompts در مقابل، فرضیههایی برای Research هستند.
این جداسازی باعث میشود داده تولیدشده توسط AI بهاشتباه بهعنوان رفتار واقعی کاربر گزارش نشود.
مشاهده AnswerPath GEO در GitHub
از Prompt Discovery تا GEO Measurement
ترکیب Question Discovery و Benchmark میتواند یک Pipeline کامل ایجاد کند:
Observed Questions → Prompt Dataset → Multiple Models → Multiple Runs → Response Storage → Entity Detection → Citation Extraction → Recommendation Detection → Competitor Comparison → Time-Series Tracking
این Pipeline نشان میدهد GEO بهتدریج از Content Optimization به سمت Measurement Infrastructure حرکت میکند.
SAGE؛ اتصال SEO، AEO و GEO
یکی دیگر از پروژههای مرتبط، SAGE — Search, Answer & Generative Engine Auditor است.
SAGE که توسط تقی مولوی توسعه یافته، تلاش میکند وضعیت یک صفحه را در سه لایه بررسی کند.
Technical SEO
مواردی مانند Canonical، Robots، Metadata، Crawlability و ساختار فنی.
AEO
Entity Structure، Structured Data، Direct Answer Density و Answer Readiness.
GEO
Semantic Chunking، Retrieval Simulation، Semantic Entropy و Citation Survival.
این مدل یک نکته مهم را نشان میدهد:
GEO جایگزین SEO نیست؛ بلکه لایه جدیدی از Measurement و Retrieval را به Search Optimization اضافه میکند.
Retrieval-friendly بودن یک صفحه یعنی چه؟
یک صفحه ممکن است از نظر Technical SEO سالم باشد اما برای RAG Systems ساختار مناسبی نداشته باشد.
برای مثال:
- چند موضوع مستقل در یک Paragraph طولانی ترکیب شده باشند.
- پاسخ اصلی در انتهای Section قرار گرفته باشد.
- Entity اصلی صفحه واضح نباشد.
- Boilerplate زیادی در صفحه وجود داشته باشد.
- Passageها بهتنهایی معنای کافی نداشته باشند.
در چنین شرایطی، URL ممکن است Crawl و Index شود، اما Chunk مناسب الزاماً در Retrieval انتخاب نشود.
این نقطه همان جایی است که Technical SEO، Information Retrieval و GEO به یکدیگر نزدیک میشوند.
آیا llms.txt بهتنهایی یک تکنیک GEO است؟
در فضای AI Search، ابزارهایی مانند llms.txt توجه زیادی دریافت کردهاند.
اما وجود چنین فایلی بهتنهایی نمیتواند افزایش Visibility را اثبات کند.
داشتن llms.txt تضمین نمیکند که:
- ChatGPT یک سایت را Citation کند.
- Gemini یک برند را Recommend کند.
- Perplexity یک Domain را Source اصلی در نظر بگیرد.
- Share of Model افزایش پیدا کند.
همین موضوع درباره Schema نیز صدق میکند.
Structured Data میتواند به Entity Clarity کمک کند، اما Authority و Recommendation را تضمین نمیکند.
در نهایت، اثر هر Technique باید با Measurement بررسی شود.
mcp-geo-server و ورود GEO به Agent Workflowها
یکی دیگر از پروژههای مرتبط با این مجموعه، mcp-geo-server است.
این ابزار با هدف استفاده از GEO Audit در محیطهای مبتنی بر Model Context Protocol توسعه داده شده است.
در چنین معماریای، یک AI Agent میتواند ابزارهای مربوط به GEO را مستقیماً فراخوانی کند.
برای مثال، Workflow آینده میتواند شامل این مراحل باشد:
- Audit صفحه
- تشخیص مشکلات Technical SEO
- بررسی Entity Structure
- تحلیل Retrieval Weakness
- ارائه یا اجرای اصلاحات
- اجرای مجدد Benchmark
- مقایسه Before و After
این فرآیند را میتوان در چهار مرحله خلاصه کرد:
Audit → Change → Measure → Learn
مشاهده mcp-geo-server در GitHub
محدودیت GEO Benchmarkها چیست؟
هر Benchmark مرتبط با LLM Visibility باید با محدودیتهای مشخصی گزارش شود.
نتیجه یک Experiment میتواند به عوامل زیر وابسته باشد:
- Prompt Dataset
- Industry
- Language
- Country
- Model Version
- Grounding System
- Execution Date
- Competitor Set
بنابراین یک Score نباید بهعنوان یک «رتبه ثابت و جهانی» تفسیر شود.
ارزش اصلی Benchmark در مقایسه شرایط یکسان و مشاهده تغییرات در طول زمان است.
Metric آینده Search شاید Rank نباشد
در Search سنتی، یکی از مهمترین سؤالها این بود:
Where do I rank?
اما در Generative Search، سؤال مهمتر ممکن است این باشد:
How often does AI know, cite, compare and recommend my brand?
در چنین فضایی، Metricهایی مانند موارد زیر میتوانند اهمیت بیشتری پیدا کنند:
- Brand Mention Rate
- Citation Rate
- Recommendation Rate
- Top-1 Recommendation Rate
- Share of Model
- Competitor Visibility
- Source Visibility
- Citation Graph
- Prompt Coverage
جمعبندی Checkup Tools
حرکت Search به سمت Generative Engineها به این معنا نیست که Metricهای کلاسیک SEO بیاهمیت شدهاند.
اما برای درک کاملتر Visibility برند، Rank بهتنهایی کافی نیست.
ابزارهایی مانند GEO-Scope، SAGE، AnswerPath GEO و mcp-geo-server نشاندهنده یک روند مهم هستند: حرکت GEO از توصیههای عمومی به سمت Experiment، Benchmark، Citation Tracking و Generative Visibility Measurement.
این پروژهها توسط تقی مولوی (Taqi Molavi) توسعه یافتهاند و بهصورت متنباز در دسترس هستند.
نکته مهم این است که هیچکدام از Metricها یا نتایج آزمایشها نباید بهعنوان قانون ثابت موتورهای هوش مصنوعی تفسیر شوند.
در یک حوزه Probabilistic مانند Generative Search، مهمترین اصل احتمالاً این است:
Don’t trust GEO claims. Test them.
ابزارها و منابع مرتبط
GEO-Scope
github.com/tmolavi/geo-scope
SAGE — Search, Answer & Generative Engine Auditor
github.com/tmolavi/sage-audit
AnswerPath GEO
github.com/tmolavi/answerpath-geo
MCP GEO Server
github.com/tmolavi/mcp-geo-server
توسعهدهنده پروژهها:
تقی مولوی / Taqi Molavi
molavi.pro


